普通のゲーム用のGPUでAIがなんとかなる時代だわ。TernaryのAPU渇望。

いやー、久しぶりに日記書きますね。
まあWTMのBotたちにも自宅LLM(AIのことです)を活用して翻訳させたり、画像解析してOCRしたり、内容を解説させたり、動画の会話とコンテキストから話し手推定させたりと、かなり活躍中ではあります。
このくらいならかなり小さなモデルでも可能なくらい各社が出しているモデルが賢くなってきたのが去年ですかね。私みたいなCUDA使えるGPUに12GBしかメモリない、もう一つAMDで安く16GB乗ってるのを買ってパワーアップ!と思ったらやっぱりCUDAの方が速い、ROCmはまだまだ苦難の道。みたいな環境ではこのくらいが限界かなと思っておりました。Vulkanがあるので実はAMD結構行けるのですが(後述)。
でも画像生成とか、動画生成とかはまあ家のゲーム用のPCでは非力すぎるかなということですな。
しかし、AIモデルの発展は止まりません。
最近は普通のチャットだけじゃなく推論(Thinking / Reasoning)が得意なのに小さなモデルというのが目白押しでございます。
ここが本当に難しいところで、Reasoningが得意なモデルというのは自分で回答した応答を読んでもう一度考えて答えを向上するループをグルグルまわしたり、必要ならツールの呼び出しとかして必要な情報を引っ張ってくることができるのですが、これを安定して精度よくできるようにするにはモデルが大きめじゃないと行けないのですわ。
しかし、大きなモデルというのは計算量が増えてしまい一回のループにかかる時間がデカいということになります。
つまり間違いなく役に立つ推論をするには大きなモデルになりがちだが、そうすると計算量増えて出力が遅くなってしまう。だから小さくして回答を早めたい。というジレンマの極貧状態なのです。
それをいろんな形ですり抜けて見た目、体感の速さをチートして上げているのが昨今のLLM業界でありまして、賢いのはMoEとかですな。
これはMixture of Expertsの略で、モデル全体としては物理が得意な部分、プログラミングが得意、Mathが得意な部分、ツール呼び出しが得意な部分とか分業したモデルがその時必要な部分だけ計算に考慮するって感じで27Bモデルなのにループ中は一番適任の4Bしか使いません。みたいな感じですな。それで知能が落ちないの?とか思うのですが、そりゃそのエキスパートたちの総合意見よりエキスパートから選抜一人の意見の方が落ちちゃうのはしょうがなくね?となるのですが、そこもちょっとしか落ちないようにもとから設計してトレーニングしてテストして改善してって繰り返すとかなりいい感じにできちゃうのですな。
なのでGemma 4 26B MoEを主に最近は使って来たのですな。結構速いし、人が読める速度の3−4倍で出力してくるので十分ストレスなく使えるし、Geminiとかと比べると知能は劣るのは明確だけどまあそこまで要らん用途が多いわけで、重宝しているわけです。
またスペアとしてGemma 4のE4Bも使ってます。26B MoEもアクチベーションは4Bのはずですが、E4Bはそもそも4Bでなんとか全部やるみたいなEdge device用、つまり非力な携帯電話とかでLLM無理くり動かすぜみたいなモデルですが、本当に速いのにそこそこ賢いのでBotが止まってしまいたくさん処理しないと行けない時とか使ってます。
で、ですなGemma 4は推論もわりと得意なんですが、私の場合OllamaもvLLMも使わないで自分でビルドしたllama.cppで回さないとスピード的に落ちるので絶対にllama.cpp派なんですが、そうなるとGGUF必須になるし、とくにAMDではROCm諦めてVulkanでうまく動くモデル限定になります。
で、Gemma 4はVulkanで結構速く動くので今まで満足してたのですが、欲が出てきてCodexとかClaudeみたいなツールを自宅LLMで回せたらウハウハだよなーと思ったところで壁にぶち当たりました。
Gemma 4の26B MoEとOpenCodeの組みあわせでツール呼び出しがどうも不安定なのですな。Gemma 4 12Bのdenseモデルも試しましたが似たような感じ。ちゃんと仕事するときもあれば何事もなかったように長い時間考えてから出力なしで死んでいるということもあります(追記:起動時に設定したctx-sizeが不足しているだけだった説あり。12Bでちゃんと設定したら行けた)。
ツール呼び出しがうまいQwen3系統に行きたいなーと思うとVulkanだとクソ遅い。CUDAだと12GBに収めないと行けないから長いコンテキスト必要なコーディングエージェントとしてはキツイ。という感じでギリギリ行けそうでいけないみたいな状況でした。
そこでちょっと注目したのがPrism MLのBonsaiです。
これがものすごく画期的というか、数年前にマイクロソフトが仕掛けた1-bitモデルであるBitnetの流れを組むデザインで普通は浮動小数点数の掛け算をいっぱいするLLMの計算を1と0の足し算に置き換えてしまうという非常に大雑把な近似をするのですが、これが意外に知能を失わないで済んでしまうという驚きの結果なのですな。だから重みがたった10分の1に!みたいな圧縮ができてしまうのでデカいモデルを非力なCPU、もしくはGPUで動かせてしまうというのが売りです。
まあLLMの重みの多くは非常に小さな少数なので丸めてそういうの全部ゼロでよくね?みたいな観測は前からあったので割と理にかなっているし、実際の神経細胞どうしのコミュニケーションも神経が発火するかしないかの0,1と見れるので生物学的にも理にかなっているという感じ。
MSのBitnetが登場した時も試してましたが、正直私の持っているPCたちでは小さなモデルしか動かず、速かったけど質が残念でしたので、今回も期待半分でこのPrism MLのバージョンを試したのが一月前ですか。その時は1-Bitを試してまあ動くけどちょっと遅いな。しかしQwen3.6 27Bを魔改造して1-BitにしたものがVulkanで動いてしまったぞ!という感じですごいことはすごかったっす。Qwen系統はだいぶ古い2.5 CoderですらVulkanは遅くて使えないので実用にかなり近づいた感じの印象です。しかし、Vulkanと相性のよいGemma 4の方が速くて使えるというのが1-bitバージョンの結論。しかし期待はやっぱり1.58bitのターナリーです。
で、先週そろそろPrism MLがメインラインのllama.ccpにPRプッシュして改善されてないかなーーと思って再挑戦してみたのですが、実は三週間前くらいから改善されていて、Ternary-Bonsaiがllama.cppの本家でも動きそうと気が付きました。がーん。
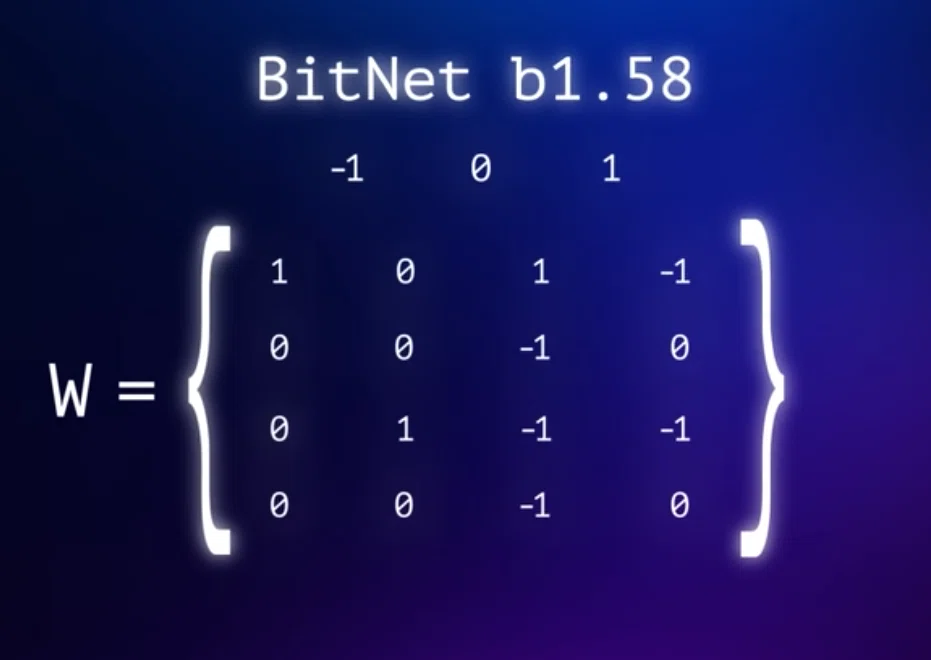
Ternaryというのは-1, 0, +1で表現するという感じで、0,1の1-bitとは違い1.58-bitとか言われます。実際の神経細胞でも興奮性の神経伝達と抑制性のがありこれまた理にかなっております。計算機科学的にはユニット単位での情報量が増えるのでクオンタイズする時に失う情報が少なくなる可能性があり、1-Bitよりこっちの方がパフォーマンスでるという期待はあるのですが、こういうのは実装がよくないと理論値に届きませんのでVulkanでこの特殊な足し算を如何にして一括処理として効率よく計算するかが肝なのです。まー、つまりやってみないとわからないわけです。
ベンチマークの結果
で、やってみたらなんと速くはなかったけど遅くもなかった感じ。Vulkanで30 tok/s。正直、Gemma 4だとVulkanは60-100 tok/s出せるのでイマイチな速度。M3 Macbookでもやったら15-20 tok/s(llamaじゃなくアップル純正MLXでやった)。CUDAだと23-28 tok/s。Vulkanが意外に健闘してる。
でも、ツール呼び出しがうまく、Thinkingモードの質がよいことが判明。つまりOpenCodeとの相性が抜群で、安定してツール呼び出ししてくれるのでGemma 4よりも使い勝手が良いのですわ。しかもモデルが27Bモデルとしては驚異的な6.8 GBとかで収まるので9 GBくらいコンテキストに余らせることができたのでコーディングエージェントとして使うには最適です。Coding agentは長いPythonのファイルとか複数読み込む必要があるのでこれがものすごく重要です。
Gemma 4は12Bでも26Bでもメモリギリギリで余裕がないクオンタイズを使用して運用していたのでContextがすぐに飽和しちゃってツール呼び出し失敗しているのかもだなー。かと言ってQ4よりクオンタイズ下げるとThinkingで馬鹿になりそうだしやりたくない。
結局、Claudeだったら5秒で出力するような簡単なコードのリファクタの仕事に20−30秒待てるならBonsaiが同等レベルの出力をしてくれるのでまあ使えるんじゃねこれ?となりました。ちょっともっさりなClaudeですわ。Claude使ってても70%くらいはHaikuで良くね?みたいな単純作業が多いですから、ほぼ満足ですわ。
追記:
なんとタブが20個開いていてYoutubeも見ていてモニターも2つのCinnamonデスクトップ環境で走っているllama.cppサーバーのBonsai-27B CUDAをopencodeのproviderに追加して、ファイル全体に残っている日本語のコメント(Geminiがぶっ込んでくる)を英訳させるタスクができちゃいました。12 GBしかないGPUなのに。驚異的。
Coding agent用にはちゃんとmodels.iniを書いてmmprojを省いたテキスト専門のモデルにオプションとして次のを追加するとギリギリいけました。
flash-attn = on
np = 1
ctx-size = 12192
cache-type-k = q8_0
cache-type-v = q8_0
temp = 0.0
top-p = 0.95
jinja = true
presence-penalty = 0.2
repeat-penalty = 1.05
設計(Planning)に関する考察
もちろん仕様書だけあげてPlanningしろとかいうClaudeでも数分考えるようなタスクはやらせてませんが、そういうのはClaudeのSonnetレベルじゃないと無理だろうなと思っています。こういうのはコンテキスト長く、そうとう賢くないと結局トークン無駄に燃やすので。自分で問題点切り分けてちょっとずつやるほうがいいと思う。
しかしですな。そのPlanningの部分は実はGeminiに丸投げすると全然Claudeいらなくなるのです。体験として。チートなのですが、半分は自分の頭を使い、半分はGeminiに任せるような感じにするとそれで十分なのですわ。
Claude使ってても自分でやりたいことが明確じゃなかったり、引っかかった問題がどこにあるのか理解できてないとClaudeが勧めてくる改善策をいくら試しても先に進めないでトークンだけが燃えていくことがあります。Claudeは高額なのでキツイですwww (OpenCode+DeepSeek V4 Flashを使えということかw)
そういうときに、Geminiさんにご意見伺いしよーっと自分で問題点のサマリーを清書していると、「あれ?ここが肝だったかな?もうちょい調べてみるか?ふむふむ、ここがこうなってこうなってるな。これをGeminiに見せるか。。。」とかなりがちで、そうやって実際のファイルとかセンシティブでGoogleなんかに見せたくない部分は一般的な問題に自分で消化して書き直して渡せば超優秀なGeminiの意見が聞けるし、清書している間に自分の頭が明確になるのもデカく、行き詰まったClaudeを正しく導けて有効活用できます。劣化がハゲしいGrokさんはこういう用途では最近は使いません。
そんな感じでClaudeあってもGeminiと併用することが多いのでいっそのこと複雑なPlanningはGeminiでやって(安いというかタダやん)、実際にできた一般的なスニペットを既存のファイルに適用するのは平凡なモデルをあてがったOpenCodeとかで編集すればなんの問題もないんじゃね?
というのを強く思いますわ。
もちろんヘビーユーザーたちがやってるSub agentsを100個走らせて同時に複数の実装プランの比較をするぜみたいな、成り金アプローチは絶対に無理ですが、自分用の小規模プロジェクトでClaudeもGoogleにも実際のファイルは見せたくねーぜみたいな用途がある私としては自宅LLMでOpenCode+Bonsai 27Bは革命的な組み合わせとなりました。ガチで使えるしBonsai頭良い。12GBでもギリギリ多分Coding agentとして使える。
Nvidia大丈夫かw
AIブームで独占的地位を築き上げ、稼ぎに稼いでいるNvidiaなんですが、今の主力GPUというのは汎用の並列処理プロセッサーという感じなので、CUDAがあっていろんな数学的なアプローチを試せる遊び場で、蓄積されたノウハウがあるので一番競争力のあるモデルはNvidia向けにチューニングされているというのが続いています。
しかしこのTernary quantizationを使うと、汎用計算機よりはむしろこれしかできない専用プロセッサーの方が安くて速くて圧倒的に有利になります。つまり専用TPUを作るか、もしくはCPUの一部にTernary向けのパイプラインを追加したAPUで、GPUは本来のゲーム用に戻る感じが非常に現実的に見えるのですわ。
おそらく今のLLMのInferrenceだけならTernary quantizationが最適解だと思われます。Fine tuningは知らん。しかし一般市民はトレーニングしないからOK。なのでNvidiaがTernaryに乗っかるのか、それとも汎用並列処理マシンでの強みを堅持するのか注目であります。
運用
運用としては普通のpython 3.12だけみたいな素のDocker imageからcode-serverやopencodeをinstallするdockerfileをGeminiと作って、そこにcode-serverの初期設定などもゴリゴリと足してdocker立ち上げたらすぐに コーディングできる環境を作って、volumeとして晒している専用のproject folder以外はopencodeからは見れないように切り分けて、プログラミングは全部Browser上で行うという感じでやっています。まあ普通でしょうな、今どき。VScode用のエクステンションが使えちゃうのでLinterとかでやっぱり助かりますし、Dockerが走っているPC以外からも入ってこれてプログラミングできるのも便利。Git repoも借りているVSPにremoteとして上げているので旅行中でもバグに対処してBotの修復とかできる。
それでWTM動画書き起こしBotさんのプログラムを色々とリファクタリングして、だいぶ読みやすくなり、マイナーな改善をいくつかしました。
それが大体終わったので、今度はGhostのGeopolitics with GhostとかBook of Trumpとかをどんどん紹介したいので、これの字幕ファイル生成パイプラインのプロジェクトへと戻ってきました。一旦高精度の字幕ファイルができるとLLMで話題ごとの見出しを作ったり、その要約作ったり、短い動画の切り出しの準備してもらったり、対応する日本語訳も文脈があるので高精度にできるし、色々とやりたいことはありますな。正直WTMの投稿よりもBadlandsのライブストリーミングの方が断然面白い状況が二年くらいは続いているのでWTMまとめよりBadlandsを見ろや!!!って叫びたいんですが、長い英語の動画というフォーマットは日本人にはキツイっすよね。
なので、できるだけこれをみなさんが咀嚼しやすいフォーマットに自動で変換して大量にnoteに置くというのを実現できたらと考えてます。
まあー気長に待っててね(`・ω・´)ゞ
おまけ
少なくともHaikuはもう要らんかもですなw pic.twitter.com/5T6Fqj2FxA
— ShironoY しろの Ph.D 英検4級 (@shironoy7) August 12, 2026
自宅LLMとかめんどいことは嫌いだ!最高レベルのモデルを安く使わせろ!という方には中華モデルのAPIを信用できるならDeepSeekとかがおすすめです。Claudeは本当に高い。すぐ財布に刺さる。うっかりThinkingに突入しないように気をつけて使うとかHaikuをメインに使うとかめんどい。
おまけ2
なんかhttps://t.co/EfKArVBOieが自動で英訳して海外からも読めるようなサービスを始めてる。
— ShironoY しろの Ph.D 英検4級 (@shironoy7) August 13, 2026
しかしその告知ポップアップの英語がすでに微妙wwww
なにこのBe sureってwww
株価落ちるぞw pic.twitter.com/iRRvM4wPEz
この記事を海外のIPから見ると出ると思われるこの警告文。Be sureとかいっていて、あれ俺なんか悪いことしたかな?なんか命令されているぞ??というすごい圧迫感のあるバナーが出るのですが、このスクショをわいのGemma 4に見せて添削したのがこちら。
もしネイティブや、まともなAIが書くなら:
Please note that AI-generated translations may not fully reflect accuracy, nuance, or the author's original intent.
(AIによる翻訳は、正確性、ニュアンス、または著者の意図を完全には反映していない可能性があることにご注意ください。)
で、褒めたら、非常に的確になぜ丁度いいのかを説明してくれる。

Dockerとかじゃなくpip installしようぜ。
これが自宅LLMの現状です。すごいよね。